Quando tudo é prioridade, alguém já desistiu de decidir
Quando todo processo recebe nice menos vinte, a prioridade máxima vira moeda de jogo de tabuleiro.
$ whoami
Julio Cezar Neves
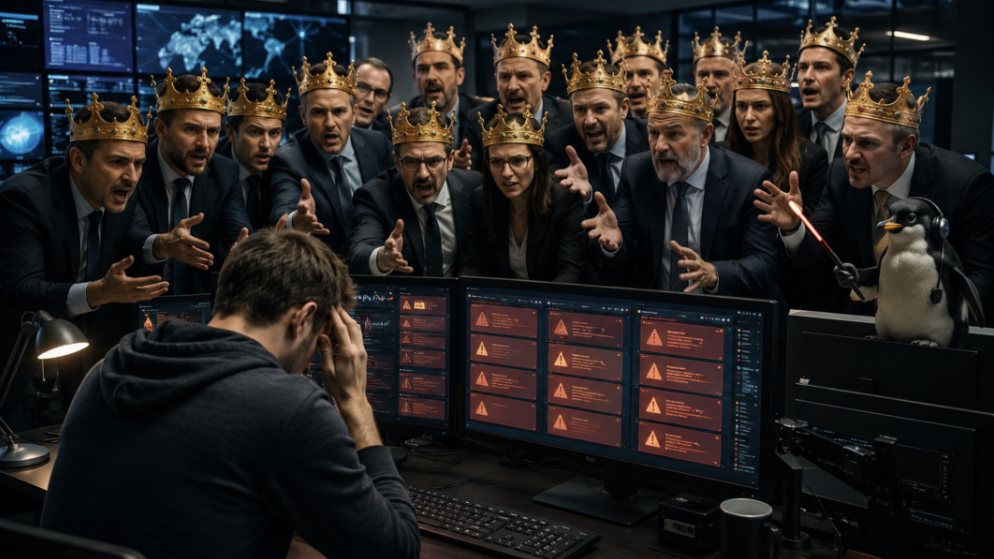
Quando tudo é prioridade, alguém já desistiu de decidir, e a fila de chamados é o lugar onde essa desistência fica registrada com data e hora. Quem trabalha com infraestrutura conhece a cena do P1 que chega enquanto outros cinco P1 esperam na mesma fila. Aquilo tem formatação de painel de controle e cara de governança. Na prática, é uma lista de incidentes críticos esperando que alguém tenha coragem de ordená-la.
O Unix resolveu essa questão há décadas com um número. Todo processo tem uma prioridade ajustável pelo nice, que vai de menos vinte a dezenove, e o kernel usa esse valor para decidir quem roda primeiro. Quando todo processo recebe menos vinte, o número perde a função de diferenciar, o escalonador volta a dividir a CPU por igual e a prioridade máxima vira moeda de jogo de tabuleiro. Para baixar o nice abaixo de zero o sistema exige root, uma barreira burocrática que muita empresa adoraria ter na própria fila.
O escalonador do Linux leva essa ideia a sério. Durante anos o posto foi do CFS, o Completely Fair Scheduler, e desde o kernel 6.6 ele pertence ao EEVDF, que segue considerando o peso de cada processo e o tempo que ele já esperou. A cada ciclo, o kernel calcula quem merece a próxima fatia de CPU e aplica o resultado sem hesitar. Ele dispensa reunião de alinhamento e dispensa e-mail de follow-up, duas vantagens que comitê algum conseguiu copiar até hoje.
Nas redes, o mesmo princípio atende pelo nome de QoS. O pacote de voz passa na frente do download pesado, porque meio segundo de atraso estraga uma chamada e passa despercebido numa transferência de arquivo. A política foi decidida uma vez e configurada no roteador, que aplica a regra a cada pacote sem convocar comitê. A discussão aconteceu antes, e por isso a execução pode ser rápida.
Esse critério tem nome, e o nome é decisão. Alguém precisa dizer que o job B espera no cron enquanto o job A termina. Quando isso falha, a causa costuma ser social, porque decidir tem custo político e ninguém quer assinar o commit que recusou a demanda de outra área. A falta de decisão também é uma decisão, só que com autoria difusa e responsabilidade rateada.
Equipes de infraestrutura vivem nesse limbo organizado. Rodam seis pipelines em paralelo, todos urgentes até o fechamento do sprint, quando todos viram secundários ao mesmo tempo. A sensação de produtividade é altíssima e o throughput real costuma ser baixo. O paralelismo, nesse caso, serve de fantasia para o desperdício de capacidade, e a fantasia cai muito bem em reunião de status.
Muita gestão adora dizer que vive num ambiente dinâmico. Em geral, a expressão descreve uma equipe que perdeu a capacidade de recusar na hora certa e por isso aceita tudo, chamando o resultado de agilidade. Quem decide bem tem uma característica incômoda para quem evita decidir, que é aceitar matar um processo para liberar memória para outro mais importante. O kernel faz isso com o OOM killer sem remorso algum, e a decisão parece óbvia até o processo escolhido ter nome de funcionalidade querida, defendida pela gerência no último standup.
Times de plataforma sentem isso de forma mais cruel. Recebem uma fila de tickets críticos e terminam o turno com a mesma fila, agora acompanhada de mais cansaço. O incidente de produção escolhe sempre o pior horário, aquele em que a fila já está saturada de SLAs condenados desde a abertura. Produção tem um senso de oportunidade que muito vendedor invejaria.
A solução costuma aparecer em algum runbook genérico, na forma de uma instrução solene para priorizar por prioridade. A frase soa profunda até alguém perceber que ela é o próprio problema, agora com número de versão e aprovação formal. Times maduros entendem isso sem precisar de dashboard. Eles mantêm poucos P1 reais, defendidos com clareza, e tratam o resto como backlog respeitável, o que exige coragem operacional vestida de severidade simples.
Na próxima fila com quinze tickets P1, vale perguntar com calma qual deles o time aceita deixar estourar o SLA primeiro. A resposta revela mais sobre maturidade operacional que qualquer relatório de uptime, e a falta de resposta no canal revela ainda mais. Costuma ser a mensagem mais lida e menos respondida da semana.
Existe uma ferramenta antiga, discreta no currículo, que resolve metade desse problema antes de a reunião de priorização começar. O shell script executa exatamente o que foi definido, na ordem certa, sem pedir aprovação a ninguém. Escrever um script obriga a decidir o que entra no fluxo e o que fica de fora, porque automatizar tudo ao mesmo tempo é impossível. O script força a priorização que a reunião adia.
Acompanhei duas pessoas que entraram juntas na mesma empresa, para o mesmo cargo. A primeira passou o ano respondendo ticket por ticket, à mão, com uma dedicação exemplar. A segunda passou as primeiras semanas escrevendo scripts para tudo que se repetia e quase sumiu das reuniões de status, porque tinha poucos tickets fechados para exibir.
Um ano depois, a segunda tinha automatizado oitenta por cento da rotina da equipe e ganhado tempo para os problemas difíceis, aqueles que exigem julgamento humano. A primeira seguia na mesma esteira, agora ensinando quem acabava de chegar a fazer exatamente o que ela fazia, à mão, todo santo dia. A dedicação era admirável, e o resultado era uma fábrica de repetição com programa de formação próprio.
Isso pesa na carreira de forma direta e raramente proporcional ao esforço aparente. Quem automatiza vira o nome lembrado quando o sistema cai numa sexta à noite. Quem só clica em painel vira o nome esquecido na promoção, mesmo com presença garantida em todas as reuniões críticas. O shell carrega a fama injusta de coisa de quem aprendeu Unix nos anos noventa, e essa fama esconde a diferença entre revisar prioridades à mão todo dia e ter um cron que fez a triagem enquanto a equipe dormia.
Um find encadeado com xargs e um awk na ponta do pipe resolvem em uma linha o que muita gente resolve com planilha e reunião de alinhamento. O comando devolve o resultado antes de a reunião começar, e dispensa pauta. Repetir à mão é treinar o erro até ele sair com boa caligrafia. Quem escreve o script uma vez para de pagar essa aula toda semana.
Existe um teste informal de maturidade técnica, conhecido de quem trabalha com infraestrutura há tempo suficiente. Basta perguntar o que o time faz quando o mesmo incidente se repete pela terceira vez. Se a resposta envolve mais uma reunião, o problema é cultural. Se envolve um script novo no repositório, o time aprendeu a transformar repetição em patrimônio, e essa diferença, ao longo de dez anos, pesa mais que qualquer certificado isolado.
Ela aparece em quem vira referência técnica dentro da empresa e em quem permanece útil e substituível na mesma cadeira por anos seguidos. As duas trajetórias começam iguais e se separam devagar, um script de cada vez. A bifurcação passa despercebida no dia em que acontece e fica evidente na avaliação de desempenho, quando já é tarde para mudar a rota.
PS: Conte nos comentários se você já trabalhou num lugar onde todo ticket era P1 ao mesmo tempo, e como a equipe sobreviveu. Tenho interesse genuíno nas estratégias de sobrevivência, e compartilhar este texto no canal da equipe pode render uma conversa honesta sobre a fila. Se a sua fila tem mais de cinco itens com nice menos vinte, parabéns, aquilo deixou de ser fila de prioridade faz tempo e virou assembleia.
$ tee # compartilhe este artigo WhatsApp Telegram LinkedIn
$ cat comentarios.log
lendo o log…